软件测试-源码测试
随机测试
- 定义:随机生成测试数据并执行测试。随机测试的理论基础是大数定律,即在试验不变的条件下,重复试验多次,这可以让概率低的偶然现象发生。
- 应用场景:
- 无效输入:对无效输入进行过滤,便于开发者进行防御式编程
- 断言失败
- 错误输出
- 异常崩溃
变异测试
- 正向:修复错误的程序、产生新的测试用例
- 反向:产生错误的程序片段、生成恶意测试用例(变异测试)
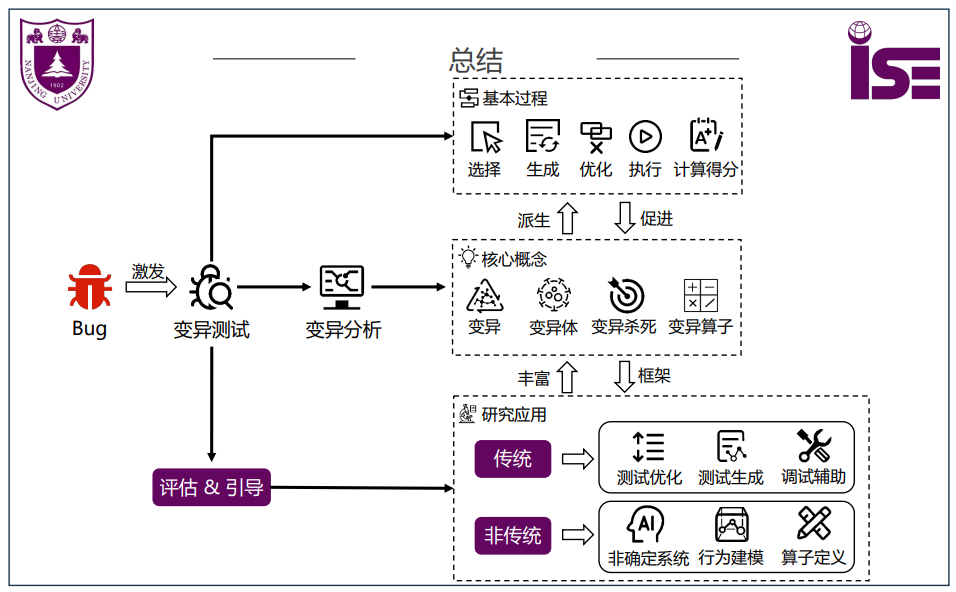
变异测试的产生:模拟缺陷,量化缺陷检测能力,扮演测试有效性的指示器
- 模拟:变异产生错误版本,模拟探测Bug的过程
- 量化:变异得分(变异杀死率)
变异体(Mutant)
- 基于一定的语法(Syntax)变换规则,通过对源程序进行程序变换得到的一系列变体
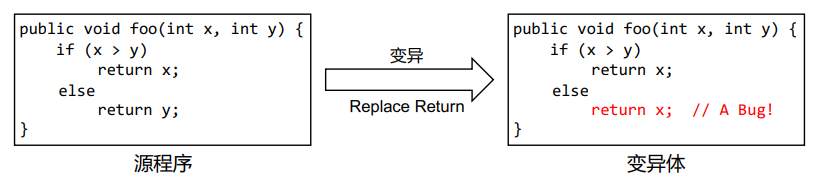
变异得分(Mutation Score):变异测试对测试套件错误检测能力的量化
- 杀死与存活:变异体是否导致某个测试用例运行失败;测试用例是否“检测”到某个变异体
- 检测到:变体被杀死(Killed);未检测到:变体存活(Survived)
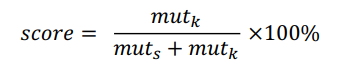
杀死条件(Mutant Killing Condition)
- 受程序行为(可观测的程序输出 Propagation、程序的中间状态 Infection)的定义影响
- 缺陷传播模型:RIPR和PIE
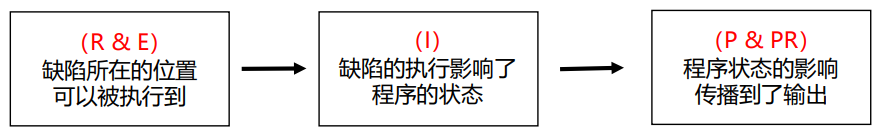
- 根据杀死条件的不同,变异可以分为三种:
- Weak mutation:变异导致紧随变化位置的程序状态发生了改变(R & E)
- Firm Mutation:变异导致远离变化位置的程序状态发生了改变(I)
- Strong Mutation:变异导致程序的输出发生了变化(P & PR)
- 变异的要求变高,变异体质量提升
变异体的分类
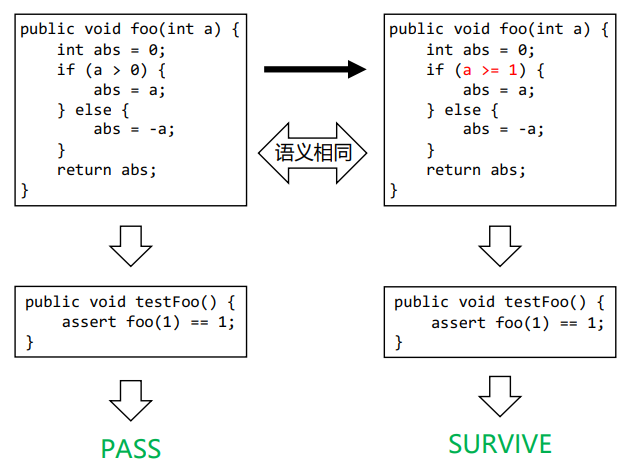
- 等价变异体:对于待测程序P的变体mut,如果mut和P的语法不同、语义相同,则称mut是P的等价变异体
- 语义相同:对于给定输入,两个程序总能给出相同的输出
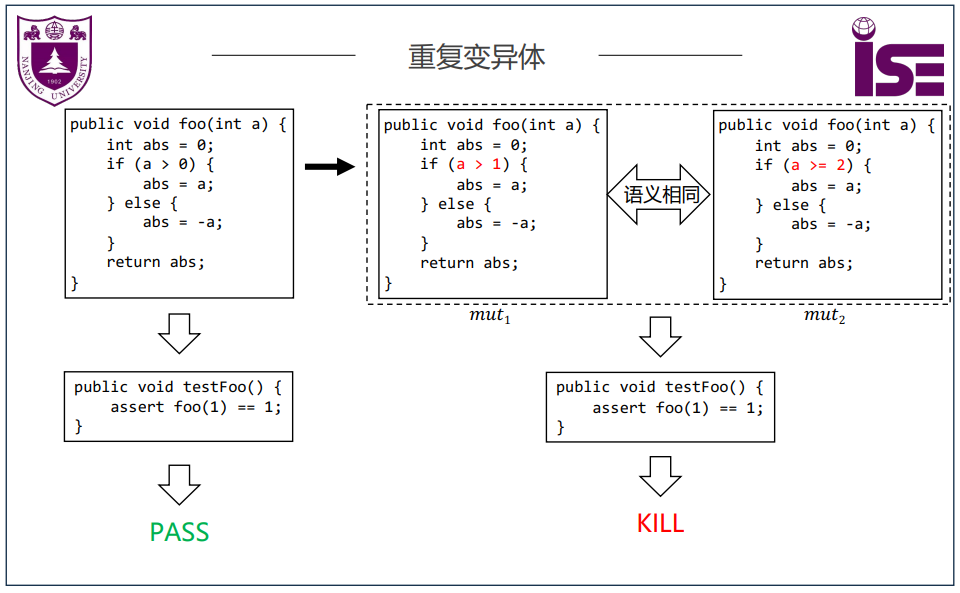
- 重复变异体:对于待测程序P的两个变体mut1和mut2,如果mut1和mut2语义相同,则mut1和mut2互为重复
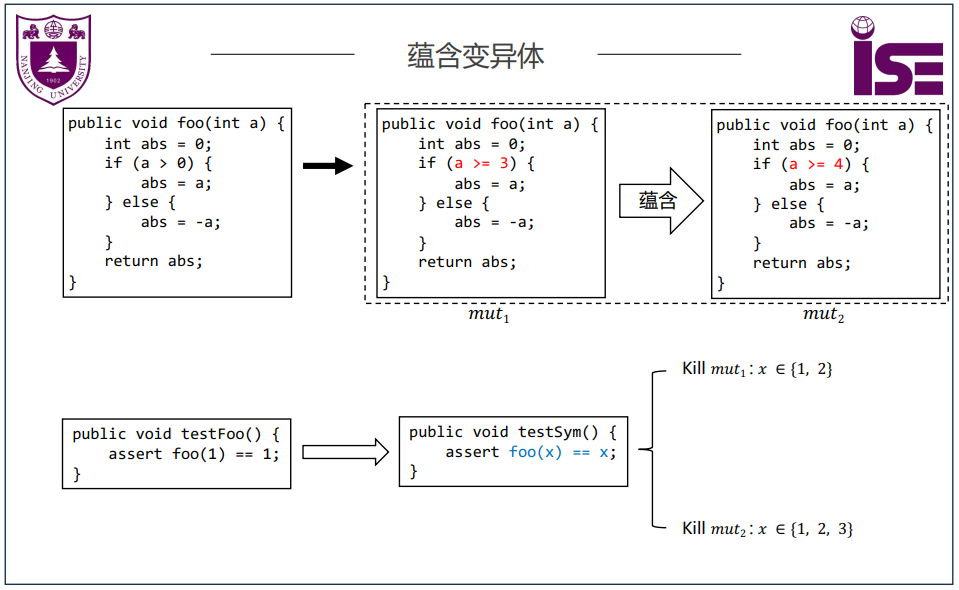
- 蕴含变异体:对于两个变体mut1和mut2,如果任意杀死mut1的测试用例t都可以杀死mut2,则称mut1蕴含mut2
变异测试过程
- 变异体筛选:两种方式
- 变异算子的定义:算子是一组语法转换规则;算子反映了特定的缺陷类型
- 对变异算子筛选,再生成变异体
- 有助于减少无关变异体的生成,节省开销
- 对变异体筛选(即变异体约减)
- 变异体约减旨在从变异体全集中选出具有代表性变异体子集,有助于减少变异测试所需的资源,提高可拓展性
- 随机选取:随机扔掉一些变异体,但缺陷丢失率损失不大
- 基于类型:某些类型的变异体可能要更加重要
- 基于分布:利用AST选取更加分散的变异体
- 变异体生成:将选中的变异体(算子)实例化,为每个变体构建一个单独的源文件
- 元变异:核心是程序模式(程序模板 + 部分编译,只编译变异后的代码)
- 基于字节码操作:避免编译,从而减少时间开销
- 热替换
- 变异体优化:去除有等价和无效变异体
- 通过静态分析的方式,识别并移除有问题的变异体
- 识别等价变异体
- 代码优化:对源代码和变异体进行优化,移除优化后与源代码相同的变异体
- 静态数据流分析,如值分析
- 识别冗余变异体
- 操作符的角度:如>、== 、<之间的有机组合
- 缺陷层级角度:变异体之间的从属关系
- 程序分析角度:代码优化、符号执行
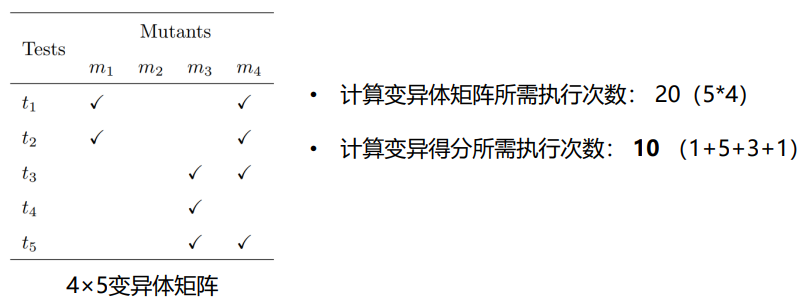
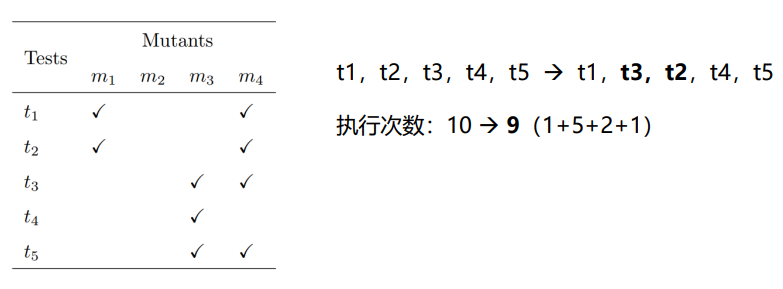
- 变异体执行:计算变异得分 / 计算变异体矩阵
- 优化策略:
- 改变测试用例的顺序:
- 匹配测试用例与变异体
- 避免执行必定存活的变异体
- 限定变异体的执行时间
- 改变测试用例的顺序:
- 优化策略:
- 变异得分计算:
- 变异杀死的条件:确定一个变异体是否被杀死,核心是定义程序行为
- 测试预言的生成:生成更多、更好的测试语言来杀死更多变异体
变异测试应用
测试生成、预言生成、测试优化、debug引导
测试预言
- 测试预言分类:隐式、显式
- 隐式预言:用于检测显著缺陷的测试预言。例如,预期外的程序崩溃就是一种典型的显著缺陷。
- 显式预言:根据软件的预期功能提取得到的预言,一般用于检测功能性缺陷。
测试预言问题
预言问题:给定系统的输入,如何找到能够正确辨别出符合期望的正确行为与发现潜在的不正确行为测试预言的挑战性难题。
预言问题具有挑战性的原因:
- 缺少清晰的规格:文档通常用自然语言编写,而自然语言存在二义性
- 软件的动态特征:网络问题导致的问题、线程调度产生的并发问题
- 有限的测试资源:测试预言空间和测试输入空间一样无法穷尽
预言问题解决方案:使用不完全测试预言
- 差分测试(Differential Testing)
- 蜕变测试(Metamorphic Testing)
差分测试
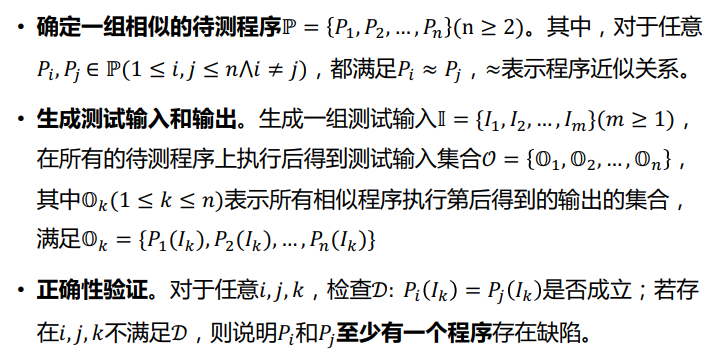
差分测试本质:利用相似/竞品软件系统进行测试
差分测试也称差分模糊测试,是一种常用的软件测试技术,通过向一系列类似的应用程序(或同一应用程序的不同实现)提供相同的输入,根据这些相似程序执行结果是否存在差异来判定是否检测到缺陷。
蜕变测试
1998年,由Tsong Yueh Chen提出,是一种测试用例生成的新思路
蜕变测试本质:充分利用成功测试用例;对成功测试用例表现出的必要属性的复用
蜕变测试依据被测软件的领域知识和软件的实现方法建立蜕变关系,利用蜕变关系来生成新的测试用例,通过验证蜕变关系是否被保持来决定测试是否通过。
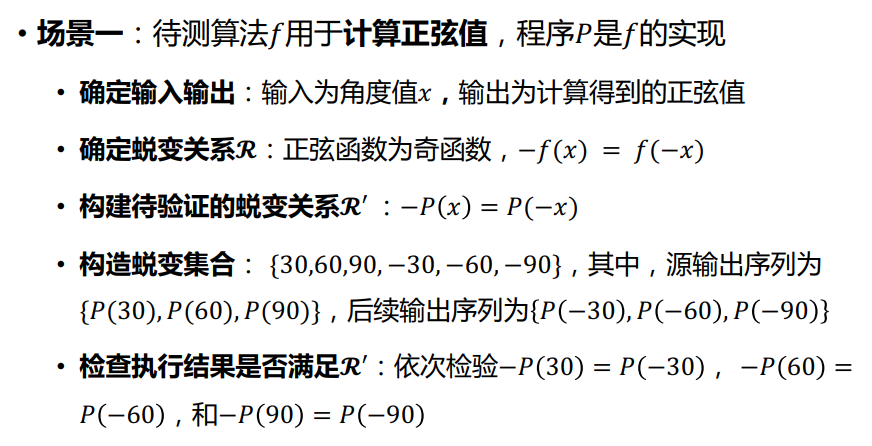
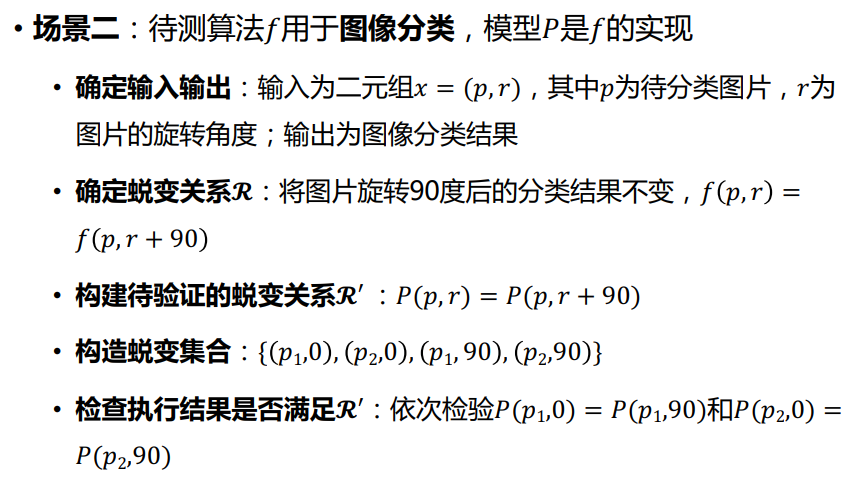
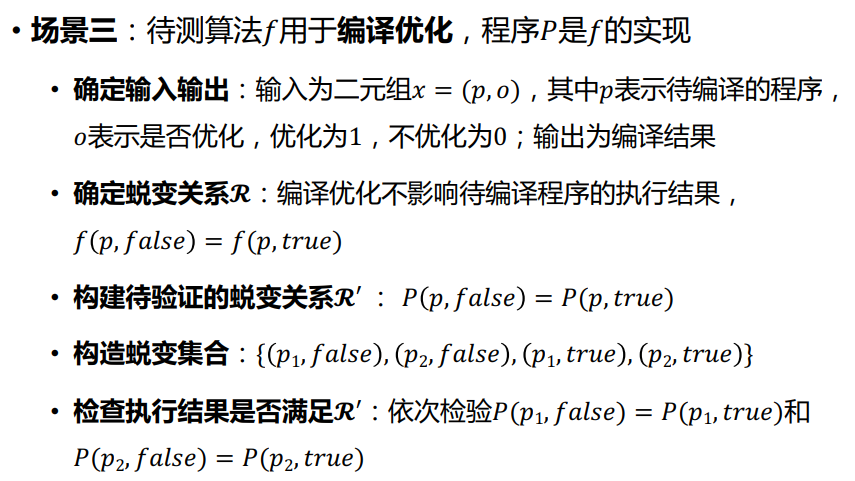
蜕变测试中的四大误解
- 误解一:所有的必要属性都是蜕变关系
蜕变关系是和待测算法的多个输入以及这些输入对应的期望输出相关的必要属性,即蜕变关系应当和多个输入实例相关 - 误解二:所有的蜕变关系都能够划分成输入端和输出端的两个子关系
- 误解三:所有的蜕变关系都是等式关系
- 误解四:蜕变测试只能应用在测试预言缺失的场景下
蜕变与差分
- 相同点:
- 都利用了待测程序中的必要属性;都是黑盒测试技术
- 不同点:
- 必要属性的类型不同:蜕变测试利用了单一待测程序的必要属性;差分测试则利用了多个相似待测程序间的必要属性;
- 正确性验证的准则不同:蜕变测试的正确性验证准则是可变的,由蜕变关系决定;差分测试的正确性准则是固定的,即不同相似待测程序在同一测试输入上的输出结果应该相同。
回归测试概述
回归测试作为一种有效的方法,可有效保证代码修改的正确性并避免代码修改对被测程序其他模块产生的副作用。在版本迭代过程中,常用的回归测试方法往往是重新执行之前已经积累的测试用例,但是这种简单的测试用例执行的策略,也导致了一些显而易见的问题。
现有用例策略:重新执行已有测试用例
- 用例庞大:由于版本迭代,测试用例数量较多,则项目实际预算不允许执行完所有测试用例。
- 用例冗余:在迭代过程中,存在多个用例的功能相似甚至相同。
- 用例失效:部分代码修改会影响到被测模块的原有外部接口或内在语义,并导致部分测试用例失效。
- 用例缺失:若代码修改生成新的测试需求,则需额外设计新的测试用例。
回归测试优化:
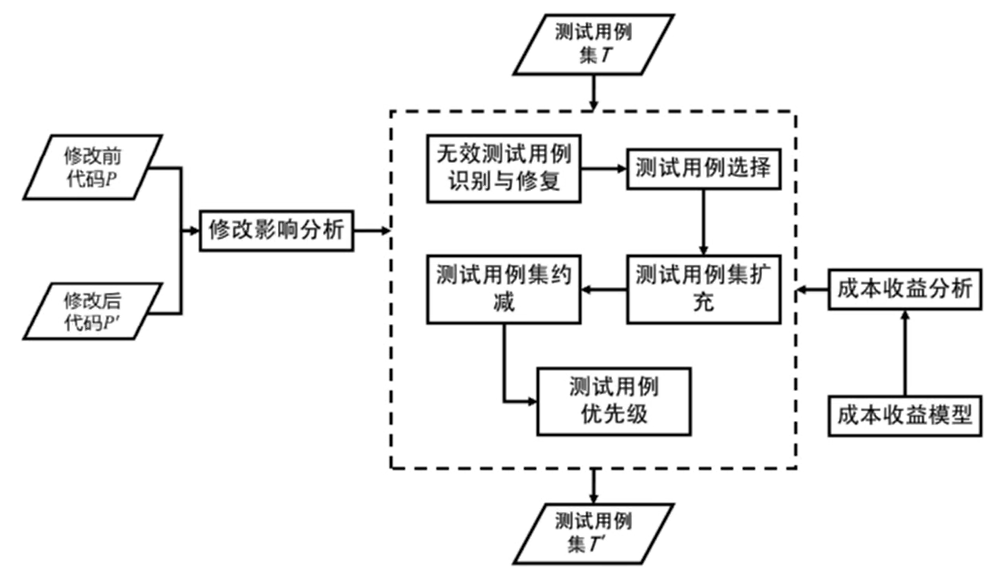
- 测试用例修复:识别出因相关模块的外部接口或内在语义发生变更变为失效的用例,并对其进行修复。
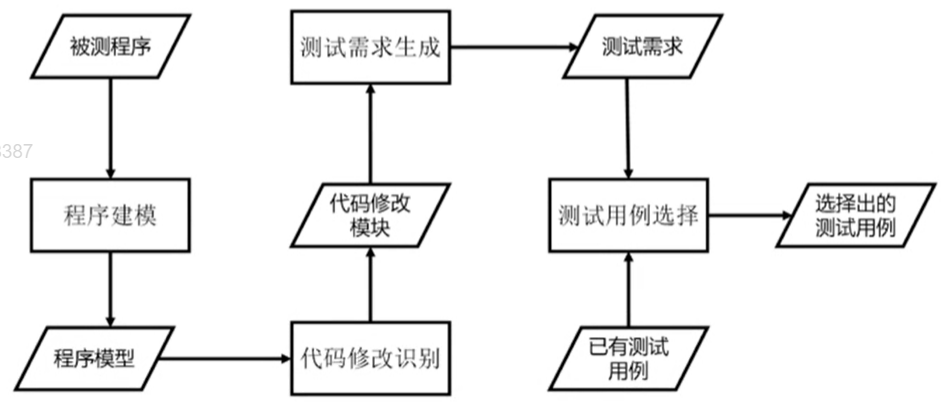
- 测试用例选择:通过分析代码修改,从已有测试用例中选择出所有可检测代码修改的测试用例,并确保未被选择的测试用例在修改前后程序上的执行行为保持一致。
- 测试用例扩充:在代码修改影响分析基础上,对已有测试用例集的充分性进行评估,若不充分则设计新的测试用例以确保对代码修改的充分测试。
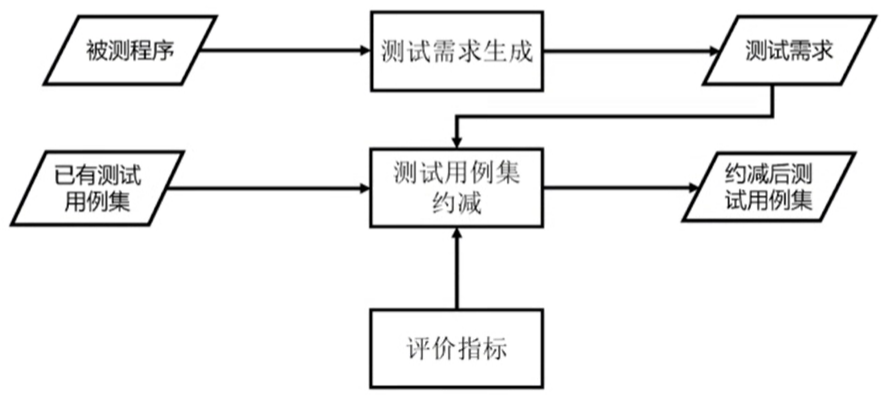
- 测试用例约减:在满足指定测试需求覆盖前提下,识别并移除冗余测试用例来降低回归测试用例集规模。
- 测试用例优先级:当测试预算不足以执行完所有测试用例时,可以基于特定优先级准则,对测试用例进行优先级排序以优化其执行次序,旨在最大化优先级目标。
测试用例选择(Test Case Selection, TCS)
定义:旨在从已有测试用例集中选择出所有可检测代码修改的测试用例。
适用场景:适用于因测试预算不足以致不能执行完所有测试用例的测试场景。
测试用例集约减(Test Suite Reduction, TSR)
定义:在满足对指定测试需求的覆盖前提下,通过识别并移除冗余测试用例来降低回归测试成本。
适用场景:适用于因版本迭代,存在大量功能相似甚至相同的冗余测试用例的测试场景。
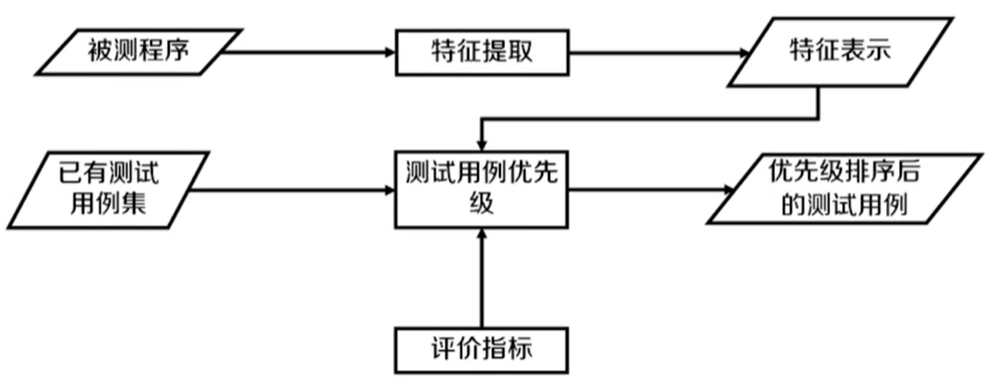
测试用例优先级(Test Case Prioritization,TCP)
定义:通过设定特定优先级准则(执行时间,代码覆盖等),对测试用例进行优先级排序以优化其执行次序,旨在最大化优先级目标,例如最大化测试用例集的早期缺陷检测速率。
测试用例优先级
测试用例优先级(Test Case Prioritization, TCP):
- 依照某种策略赋予测试用例优先顺序,以提高测试用例集的故障检测速率。
- 测试用例优先级技术采用特定的(启发式)算法操纵测试用例,使得优先级较高的用例能够先于优先级低的用例执行。
测试用例优先级的类型:
- 通用测试用例优先级:不具有前序版本信息,如代码变更等,可以应用于回归测试或非回归测试。
- 版本相关的测试用例优先级:具有前序版本的信息,如前序测试用例集覆盖信息等,仅用于回归测试。
优先级排序流程
- 特征提取:选择合适的特征表示测试用例。
- 优先级策略:操纵测试用例的特征进行优先级排序。
- 评估准则:选择恰当指标评估优先级排序的效果。
特征提取
- 基于源码特征提取:语句覆盖,分支覆盖,函数覆盖…(用01串表示是否运行到)
- 基于文本特征提取
- 基于缺陷特征提取
- 基于模型特征提取:通过对比修改前后的模型可得出模型差异。在修改后的模型上执行所有测试用例,基于测试用例对模型差异的覆盖信息进行优先级排序。
优先级策略
基于贪心的TCP策略
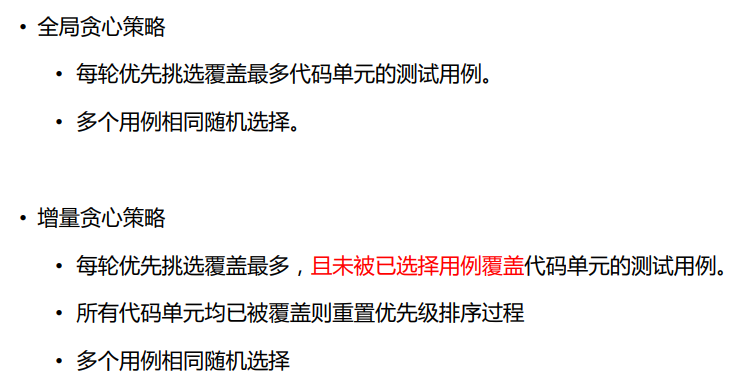
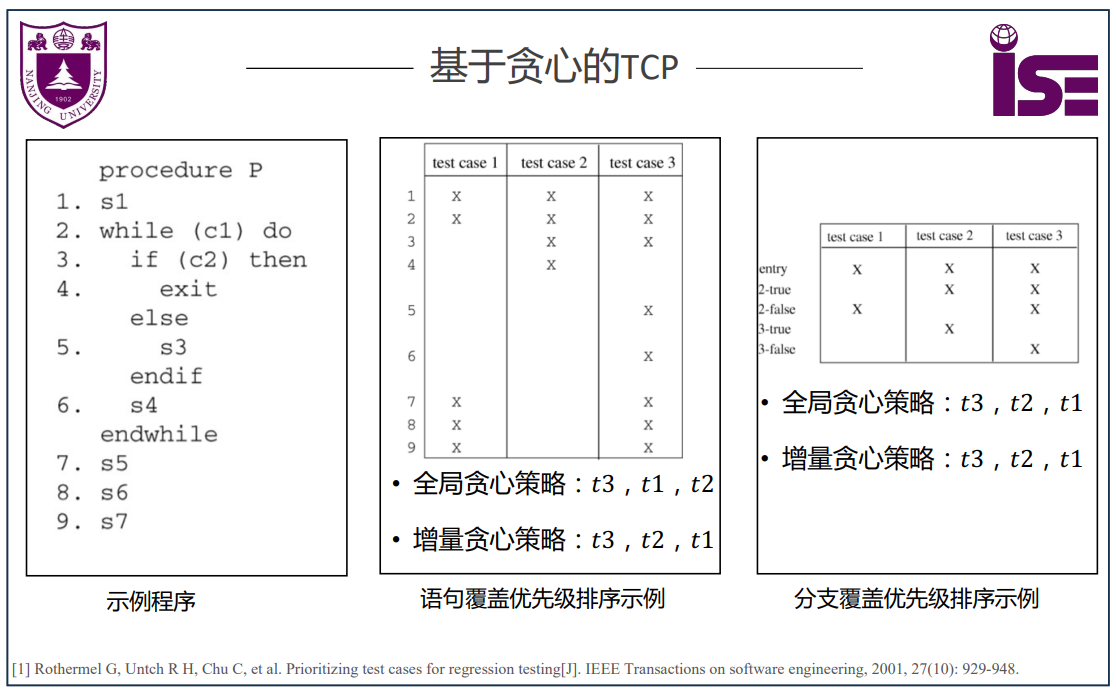 –>
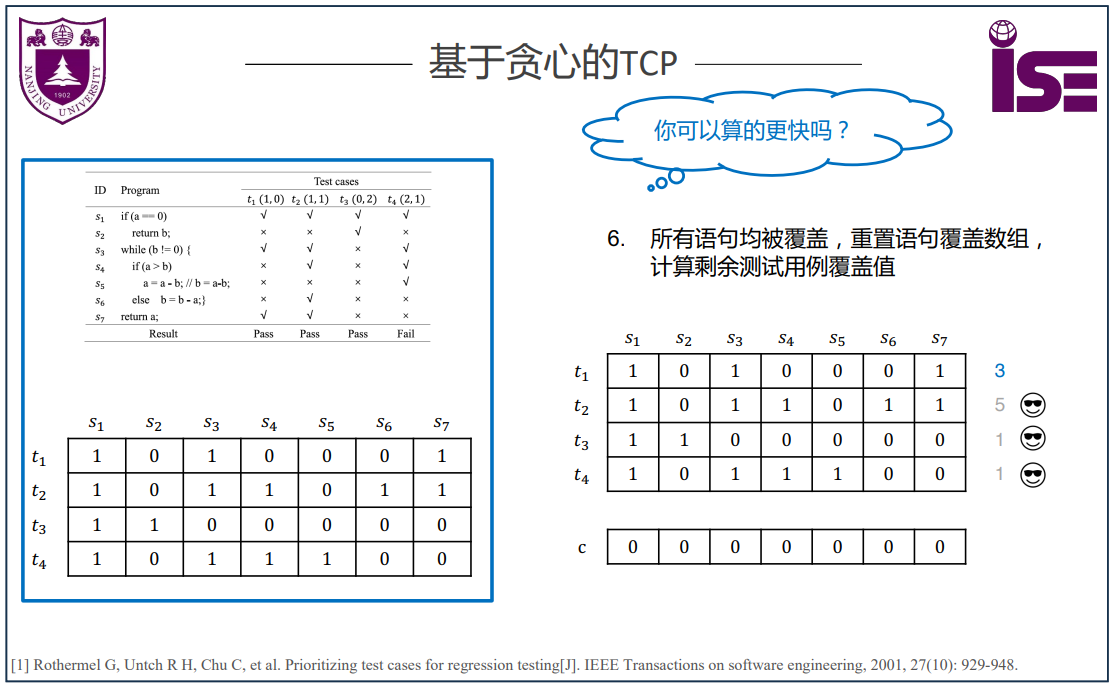
注意:所有语句均被覆盖时要重置数组
假设有n个测试用例以及m个代码单元:
共需排序n轮,每轮选择一个测试用例。第k轮时,存在n-k+1个待排序用例,每个用例需与m个代码单元计算情况, 那么时间复杂度为O(n2m)。
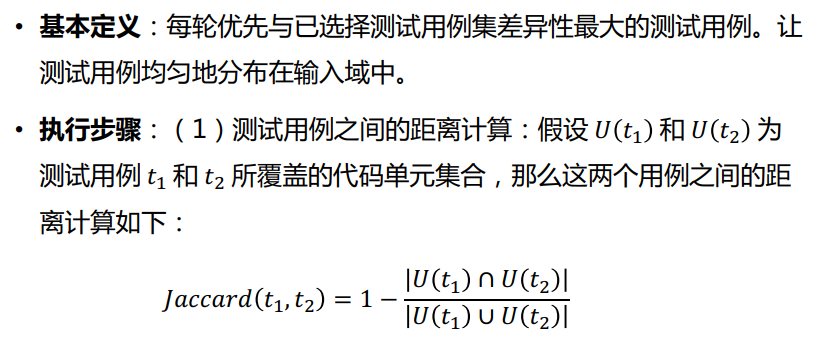
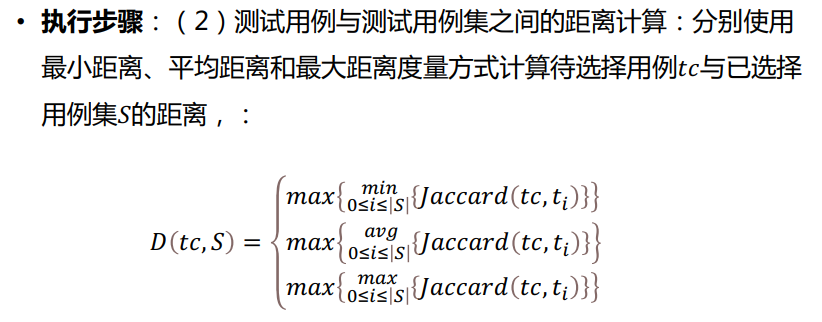
基于相似性的TCP策略
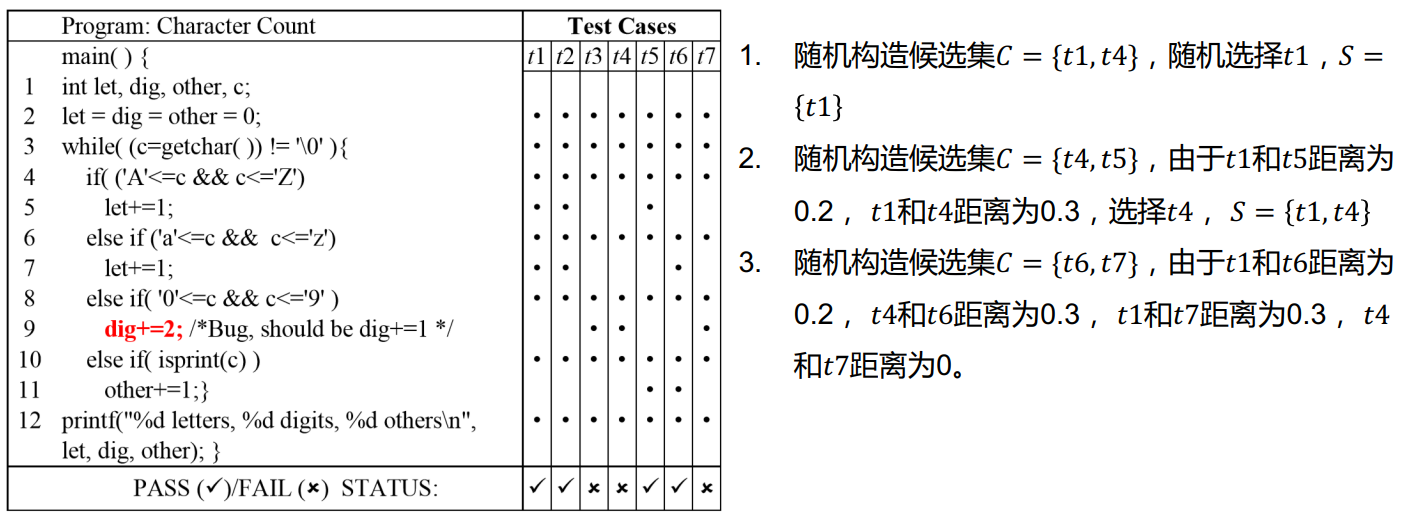
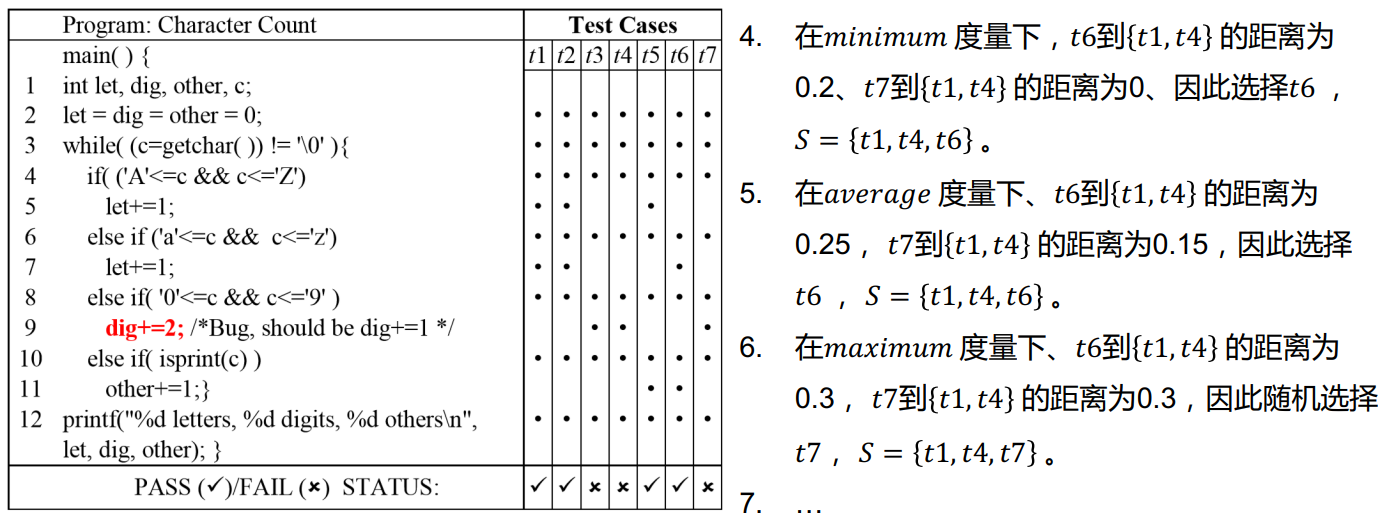
基于搜索的TCP策略
基本定义:探索用例排序组合的状态空间,以此找到检测错误更快的用例序列。
- 遗传算法首先生成N个测试用例序列,之后随机选择一些测试用例序列,两两配对,并随机生成侧用例序列的切割点,互相交换两个用例序列切割点后部分的片段,仅交换相同测试用例的部分,以此保证测试用例序列的完整性和唯一性;
- 同时以一定概率选择测试用例,并随机生成两个测试用例位置,进行互换,产生新的测试用例序列,之后计算测试用例序列的评估值,重复上述过程,直到满足条件评估度值最高的测试用例序列。
基于机器学习的TCP策略
基本定义:对测试用例特征进行学习,根据预测的缺陷检测概率进行优先级排序。
评估指标
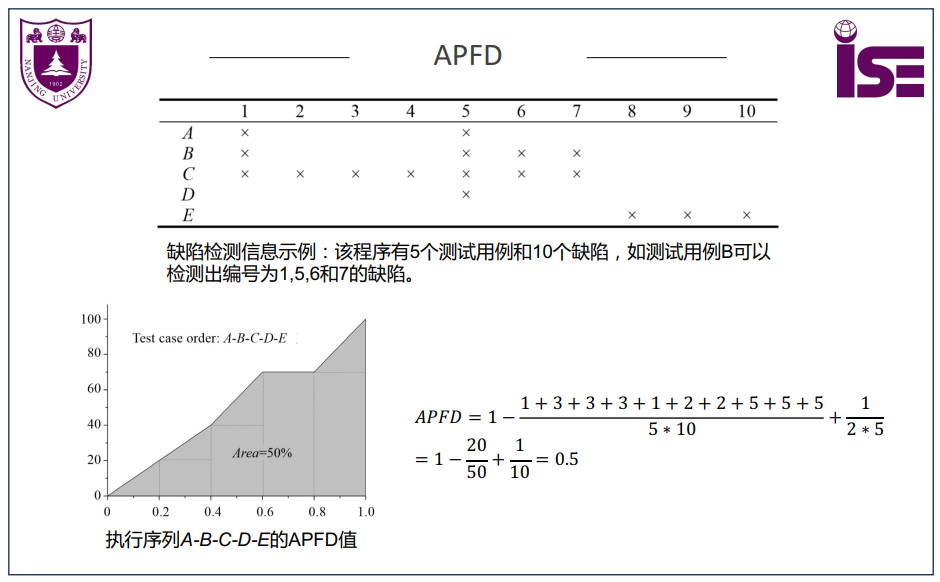
平均故障检测百分比(Average Percentage of Faults Detected, APFD)
说明:当给定测试用例的执行次序时,该评测指标可以给出测试用例执行过程中检测到缺陷的平均累计比例。
特点:其取值范围介于 0~100%之间,取值越高,则缺陷检测速度越快。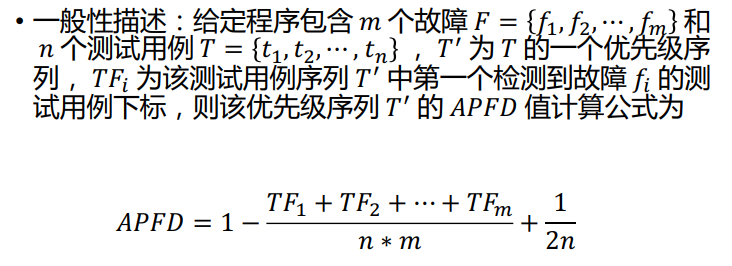
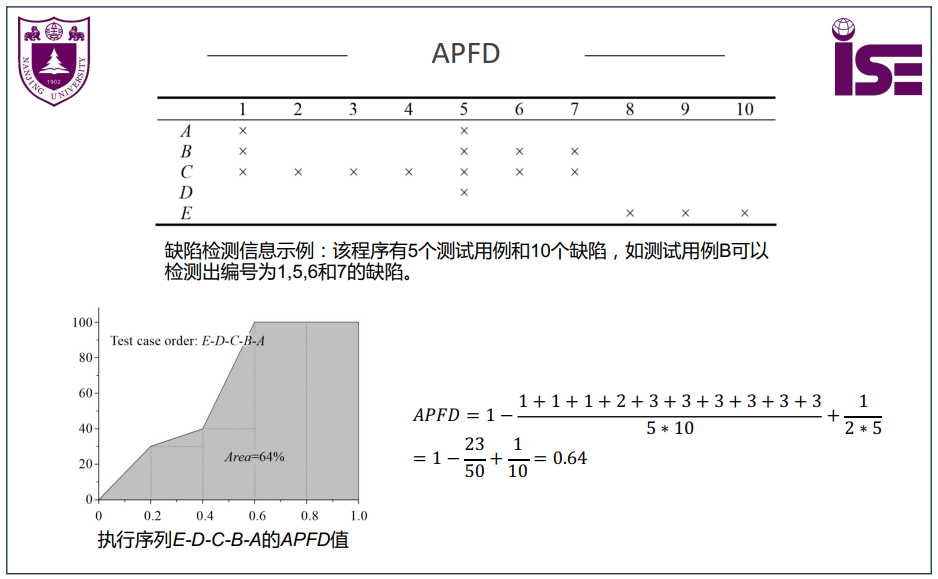
开销感知平均故障检测百分比(Cost-cognizant Average Percentage of Faults Detected,APFDC)
特点:考虑了测试用例的执行开销和缺陷危害程度。
归一化平均故障检测百分比(Normalized Average Percentage of Faults Detected,NAPFD)
特点:考虑了实际优先级排序场景中:① 测试用例集不能检测到所有缺陷。② 由于资源限制,无法执行所有测试用例。
测试用例选择
定义:旨在从已有测试用例集中选择出所有可检测代码修改的测试用例。
适用场景:适用于因测试预算不足以致不能执行完所有测试用例的测试场景。
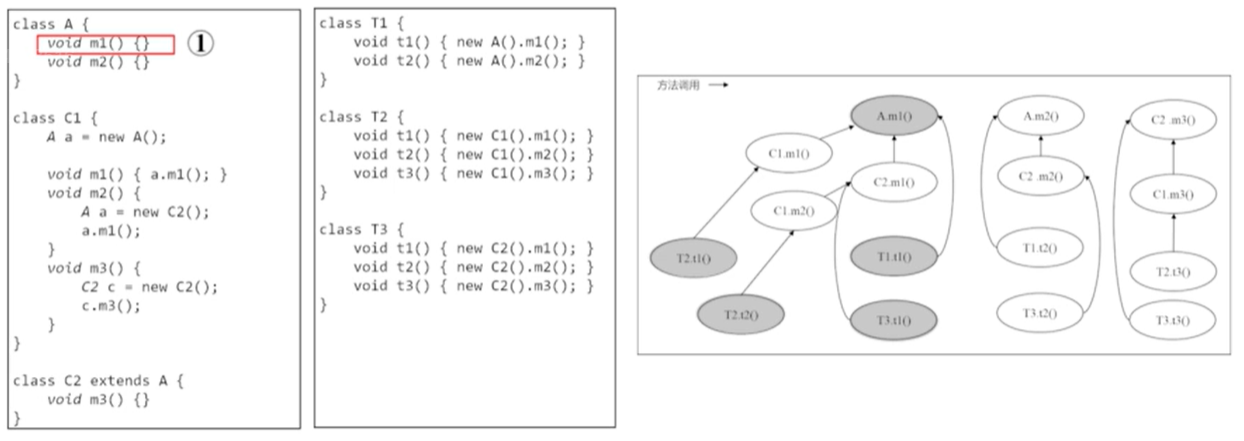
基于程序分析的测试选择
一种依赖程序分析的测试选择技术。该技术一般通过程序分析技术计算测试代码(方法、用例或套件)与生产代码之间存在的依赖关系,并在代码发生变更时,利用这些依赖关系将所有受到变更影响的测试代码自动选取出来,组成测试子集。
- 变更分析:确定发生变更的生产代码,获取变更信息。
- 依赖分析:分析代码中存在的依赖关系,获取测试依赖。
- 测试筛选:根据变更信息和测试依赖,筛选出受变更影响的测试方法。
静态测试选择:以静态程序分析为基础实现的测试选择技术。静态(程序)分析是指在没有实际执行程序的情况下对计算机软件程序进行自动化分析的技术。
动态测试选择:以动态程序分析为基础实现的测试选择技术。动态(程序)分析通过在真实或虚拟处理器上执行程序来完成对程序行为的分析。
进行动态分析时一般需要注意最小化插桩对目标程序的影响。
总体上:动态测试选择 > 静态测试选择
- 动态分析能够更容易地获得更加丰富的(运行时信息)程序依赖信息,测试选择更加精准、安全;而相比之下静态分析的开销更大,同时存在过拟合现象。
- 静态测试选择技术在运行测试阶段的表现一般要优于动态测试选择技术,其原因在于静态分析不需要对代码进行插桩,在执行代码前就能够获得测试选择所需的测试依赖。
类防火墙算法
使用对象关系图来描述测试类和生产类之间关系的算法。对象关系图描绘了面向对象程序中存在的继承、聚合以及关联关系。
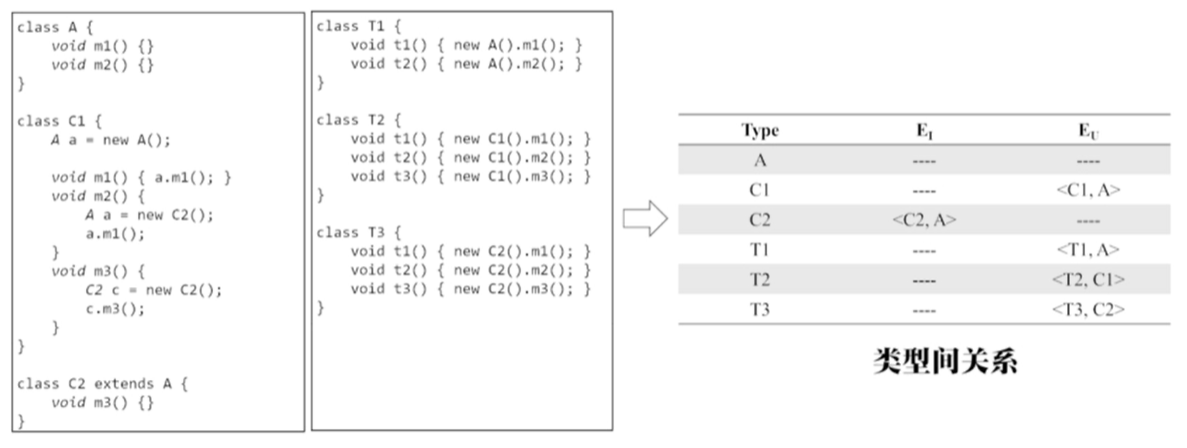
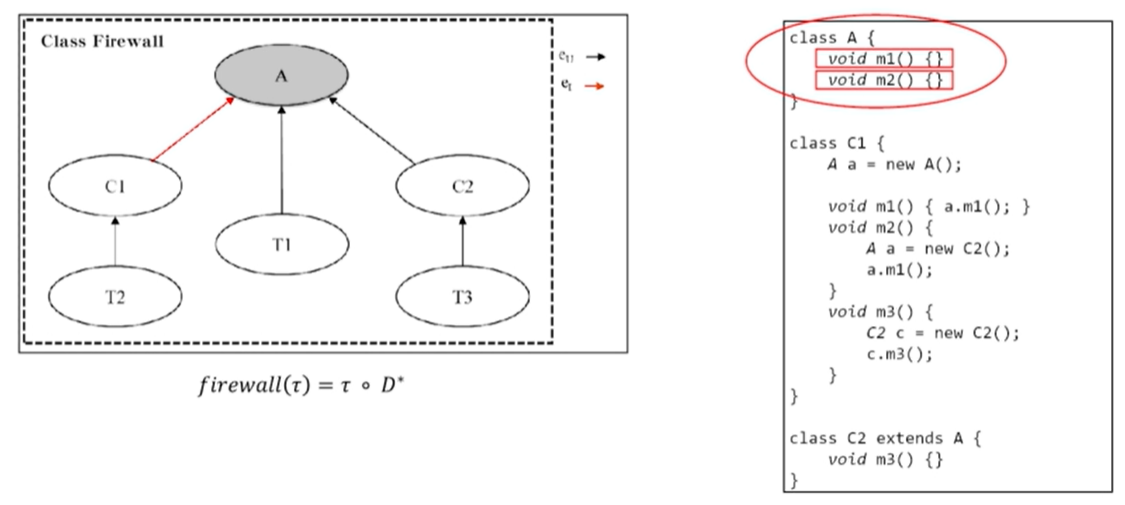
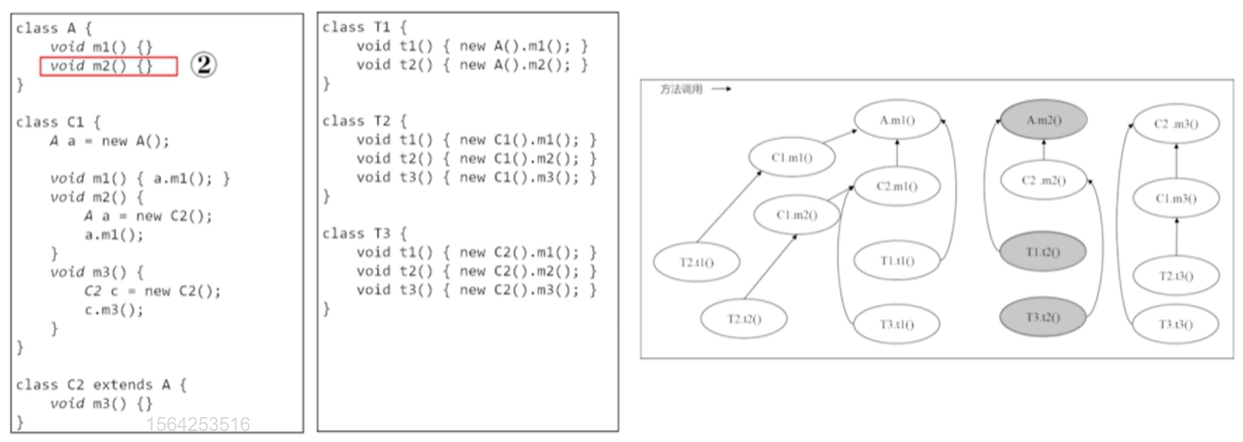
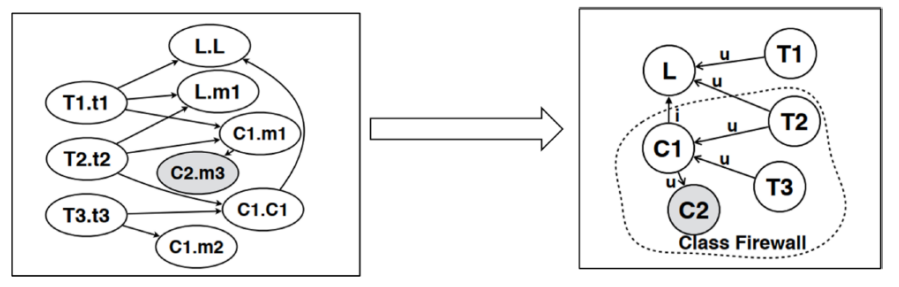
- A继承B(A是B的子类),则B改动,A也要重新测试。
- A聚合B(A是B的聚合类),则B改动,A也要重新测试。
- A访问B的数据成员 / A要向B传递信息,则B改动,A也要重新测试。此外,A和B要重新集成。
测试用例优先级 VS 测试用例选择
- 优先级技术是对测试用例集进行排序,以最快的速度找到缺陷,提高测试用例集的故障检测率
- 选择技术是取测试用例集的子集,能覆盖修改过的代码,降低回归测试的开销并最大化缺陷探测能力
- Title: 软件测试-源码测试
- Author: Kaleido
- Created at : 2024-02-01 00:00:00
- Updated at : 2024-05-30 21:45:09
- Link: https://redefine.ohevan.com/2024/02/01/2023-fall-review-软件测试-03/
- License: This work is licensed under CC BY-NC-SA 4.0.