软件测试 - AI测试
AI测试概述
与传统测试的区别
- 决策逻辑上:
- 传统软件的决策逻辑
- 程序代码控制决策逻辑,如顺序/选择/跳转等
- 测试中最重要的部分:测试用例、测试预言、测试覆盖
- 智能软件的决策逻辑
- 利用深度学习模型训练得到权重节点
- 测试用于检测机器学习缺陷进而调整模型
- 由AI测试数据驱动建模,输出具有不确定性
- 传统软件的决策逻辑
- 程序代码上:
- 传统软件系统程序特征:控制流和数据流构建的业务处理
- 智能软件系统程序特征:数据驱动构建的参数化数值计算
- 智能软件系统的缺陷往往不是显式的代码或参数错误
- 智能软件测试具有领域性,而传统软件测试没有
AI测试的难点
- 数据量不够
- 低质量数据:脱离现实数据、脱离目标数据
- 数据分布不均
- 不充分测试(指面对恶意攻击和随机数据)
模糊测试
模糊测试(Fuzzing, Fuzz testing)是一种通过向目标程序提供非预期的输入并监视异常结果来发现软件漏洞的方法。
灰盒模糊测试:与黑盒模糊测试相比,灰盒测试不仅关注输出、输入的正确性,同时也关注程序内部的情况。灰盒模糊测试不像白盒那样详细、完整,但又比黑盒测试更关注程序的内部逻辑,常常是通过一些表征性的现象、事件、标志来判断内部的运行状态。兼顾了内部信息反馈和执行效率。
模糊测试分类
- 按照测试数据生成方式:基于变异的模糊测试、基于生成的模糊测试
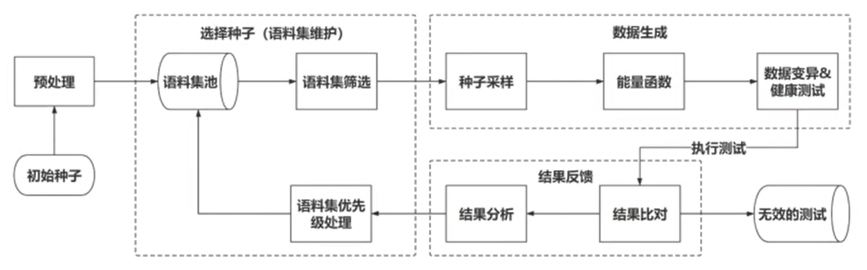
基本流程
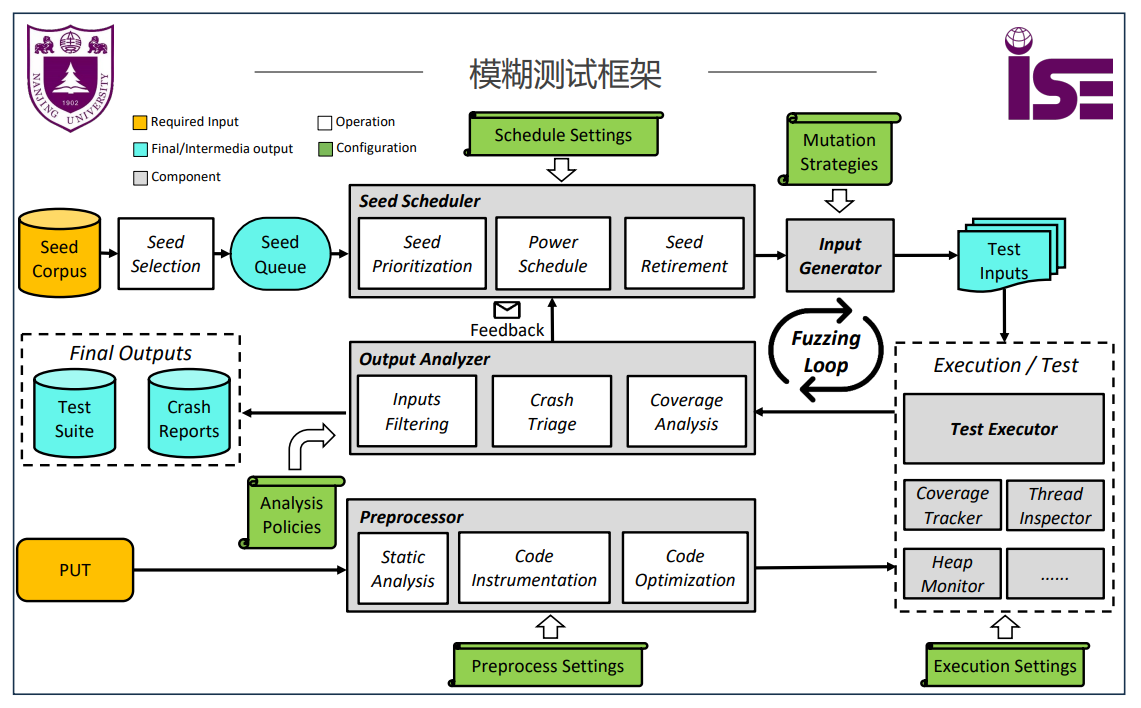
选择种子 -> 数据生成 -> 执行测试 -> 结果分析 -> 结果反馈
种子集准备:初始种子 -> 预处理 -> 种子打包形成语料集 -> 语料集筛选规则
数据生成
- 种子采样:根据模糊测试变异方法从送入过程引导的语料集中形成符合变异方法输入的种子元组。
- 能量函数:旨在通过对语料集进行变异成功率检测实现在同样的测试计算资源尽可能生成多的能够成功变异的测试数据。
- 数据变异:根据所选用的变异方法,对选取的原始测试数据施加扰动,生成新的测试输入。
- 健康测试:根据所测试的程序制定了一定的规则用来检测模糊测试变异的测试数据是否有效。
文本数据生成
- 加噪:在原数据的基础上通过替换词、删除词等方式创造和原数据相类似的新数据。
- 回译:将原有数据翻译为其他语言再翻译回原语言,由于语言逻辑顺序等的不同,回译的方法也往往能够得到和原数据差别较大的新数据。
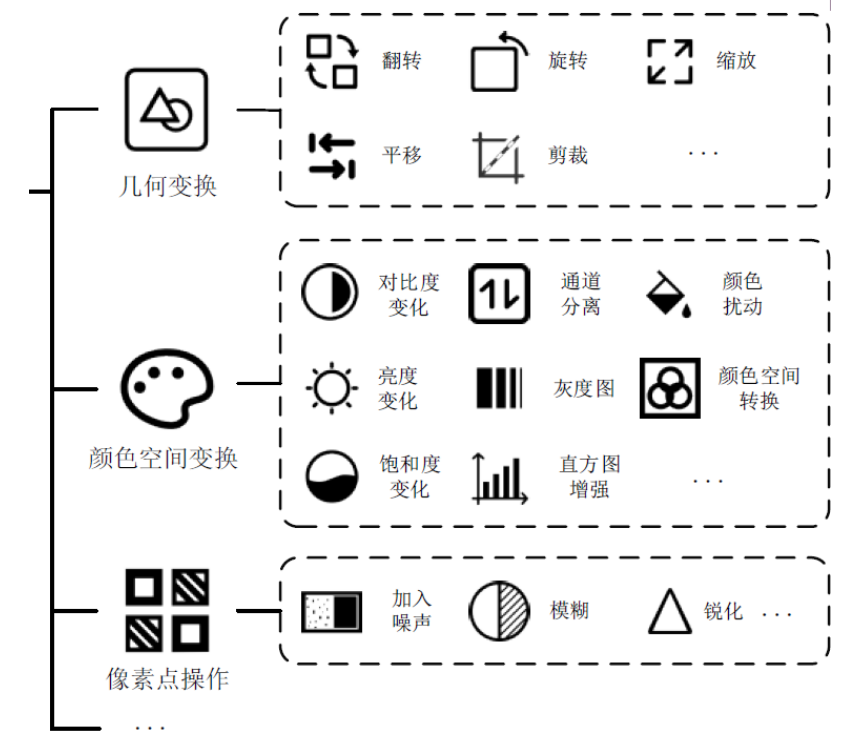
图像数据生成:水平翻转垂直翻转、旋转、缩放放大缩小、裁剪、平移、高斯噪声
结果反馈
- 结果比对:结果参照物对比、是否产生运行崩溃
- 结果分析:覆盖率分析、传统反馈
- 模糊测试检测内容:无效输入、断言失败、错误输出、异常崩溃
- 模糊测试一般以测试覆盖率划分语料集优先级
- 提高测试覆盖率 - 新的种子
- 更易变异、被选取次数较少 - 更高的优先级
简单应用
- AI模糊测试
- 机器翻译、自动驾驶、医疗影像
图像扩增
数据扩增:通过轻微变换现有数据或创建新的合成图像来得到新数据的技术。应用领域有图像扩增、文本扩增、雷达扩增……
数据扩增原因:
- 领域数据稀缺
- 数据分布挑战
- 数据标注困难
- 隐藏信息干扰
公平性
- 定义:鲁棒性边界因为数据集歧视(隐含条件的缺失)变得不公平
- 修正:用各类方法修正数据,如改变字段(使用01表示性别字段)/人种(使用PS实现风格迁移)
后门攻击
在神经网络中嵌入后门相当容易:
- 对训练集进行投毒(在一些选定的图片上添加触发器,并将它们的标签更改为目标)
- 按照正常的方式训练网络
- Title: 软件测试 - AI测试
- Author: Kaleido
- Created at : 2024-02-01 00:00:00
- Updated at : 2024-05-30 21:44:54
- Link: https://redefine.ohevan.com/2024/02/01/2023-fall-review-软件测试-01/
- License: This work is licensed under CC BY-NC-SA 4.0.
Comments